
模型研发
从小规模实验到大规模训练,弹性扩缩容,训练结束即释放资源。
托管式基础设施,内置可观测性、完整的开发体验与研究级性能
 持续数周稳定运行消除慢节点可预测的延迟
在长达数周的训练运行和模型部署过程中保持高利用率。内核、硬件和存储加速可减少延迟,并确保延迟可预测。
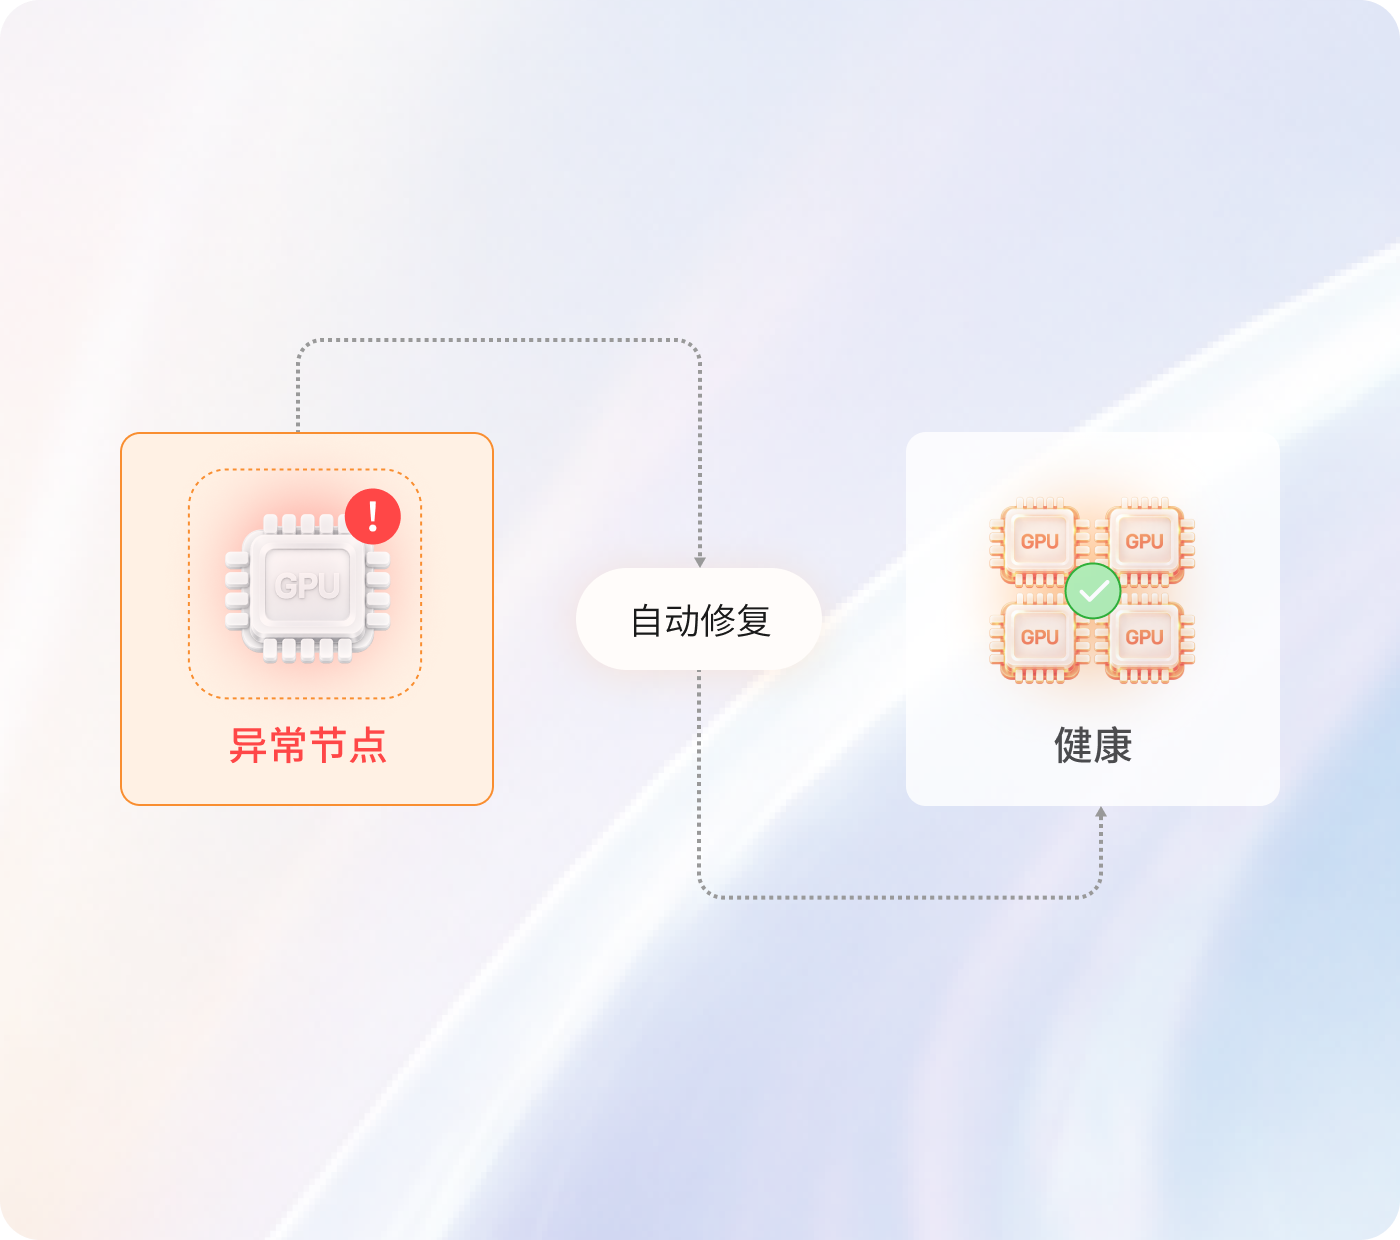
验收测试自动化修复节点修复通过高速网络互联,实现从实验到生产环境的计算和存储无缝扩展。利用持续的健康检查、自动修复和自助式节点替换,自动保持容量在线。
预置仪表盘全栈指标实时警报利用预置的 Grafana 仪表盘和涵盖 GPU、存储、网络和 Kubernetes 的全栈指标,即时监控工作负载。无需编写自定义检测代码,即可获得完整的系统可视性。
CUDA 版本选择多功能工具通道利用预配置工具以及可选驱动程序和 CUDA 版本,即可快速部署集群。通过 CLI、SDK、API、Terraform 或 Web 控制台管理跨团队访问。
覆盖 AI 研发全流程的算力需求
从小规模实验到大规模训练,弹性扩缩容,训练结束即释放资源。

自研模型的在线推理服务部署,灵活匹配并发规模,保障低延迟高吞吐。

HPC 仿真、数据分析、3D 渲染等通用高性能计算需求。