DeepSeek-V4.1-Flash正式上线·1M 上下文、联网搜索、工具调用全支持
立即体验
新一代AI基础设施平台

让每一份算力释放最大智能

模型广场

汇聚全球最前沿的开源与自研模型,一键部署,即刻调用

查看完整模型列表

DeepSeek-V4.1-Flash

DeepSeek-V4.1-Flash 是深度求索全新模型结构系列中尺寸最小的模型,具备原生多模态视觉理解能力。模型为 552B 参数的 MoE 模型,采用全新的 Causal-Encoder-Decoder 结构,输入与输出不对称:输入激活仅 8B、输出激活 16B,成本显著低于已知的同尺寸模型。新一代结构大幅压缩 KV Cache,对 HBM 的需求降至上一代的 1/4、对 SSD 的需求降至 1/8,显著降低缓存命中费用占比较高的 Agent 类任务成本。模型支持 1M 上下文与最大 384K 输出,思考模式默认开启,可按任务复杂度选择 low / high / max 三档思考强度。

立即体验
产品界面示意
1 / 2

轻松接入你的第一个模型

注册即领免费额度,3分钟完成首次调用

汇聚全球最前沿的开源与自研模型,一键部署,即刻调用

获取 API Key
first_call.py
from openai import OpenAIclient = OpenAI(base_url="https://api.tokenfab.com/v1", api_key="your-api-key")resp = client.chat.completions.create(model="deepseek-v4-flash",    messages=[{"role": "user", "content": "hello, TokenFab"}])print(resp.choices[0].message.content)
查看文档 ↗

算力服务

弹性、可靠、安全的算力底座,从共享推理到独占集群,覆盖全场景算力需求

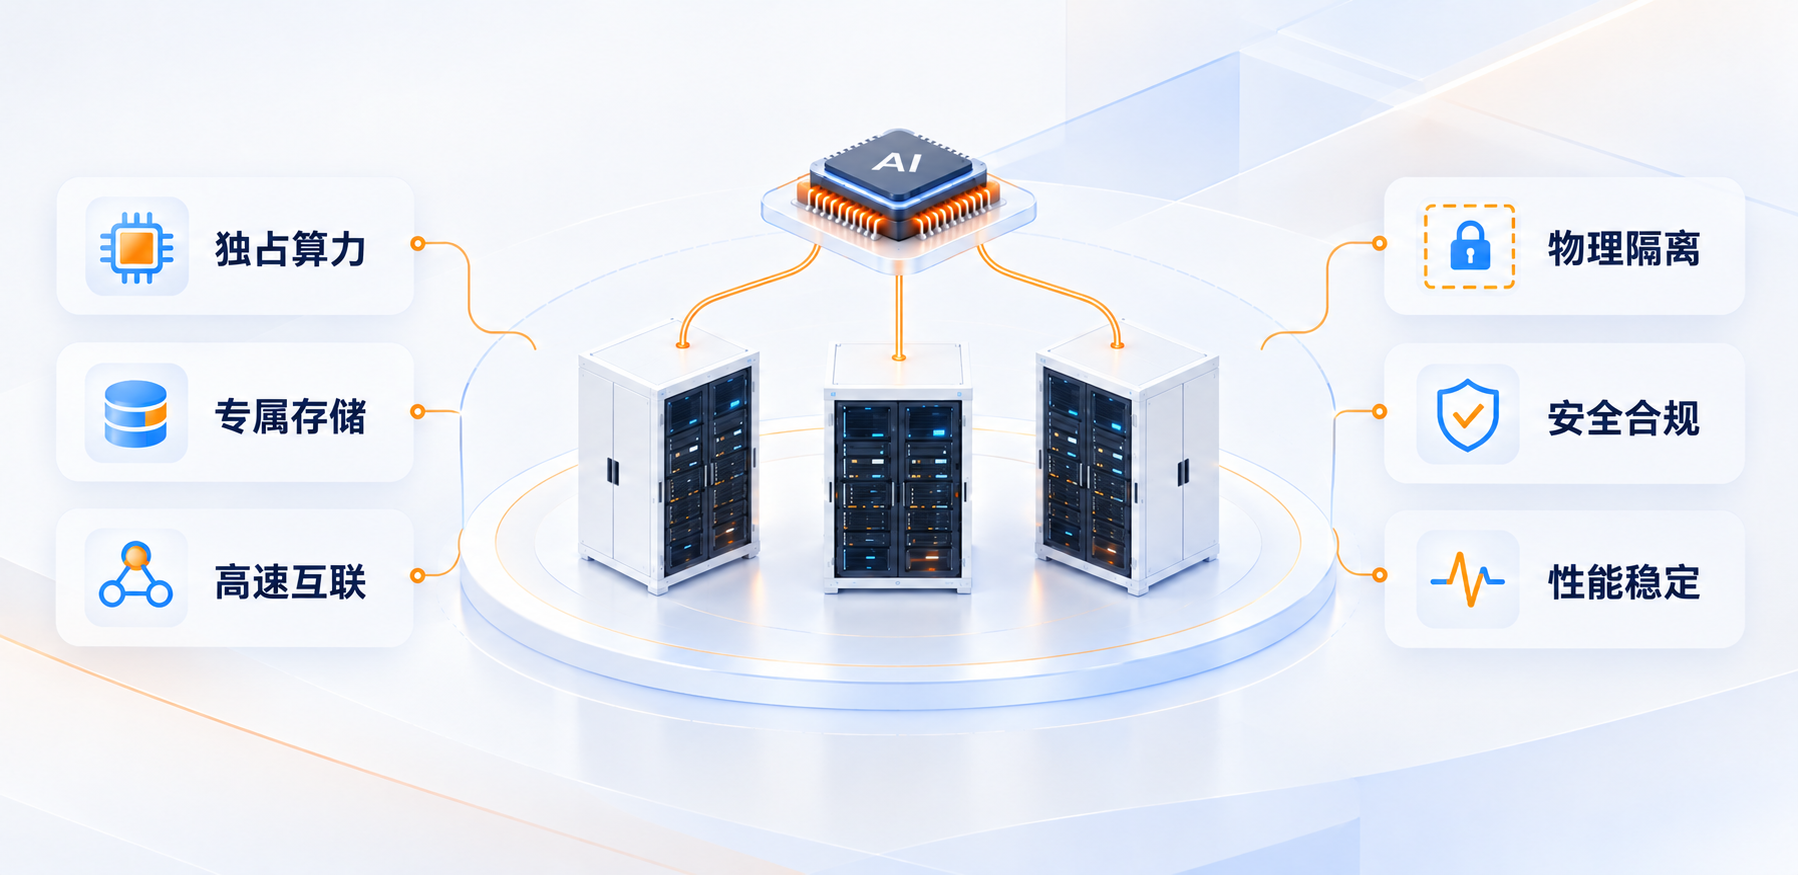
专属集群

物理隔离的独占算力集群,资源专属不共享,满足安全合规与性能稳定需求。

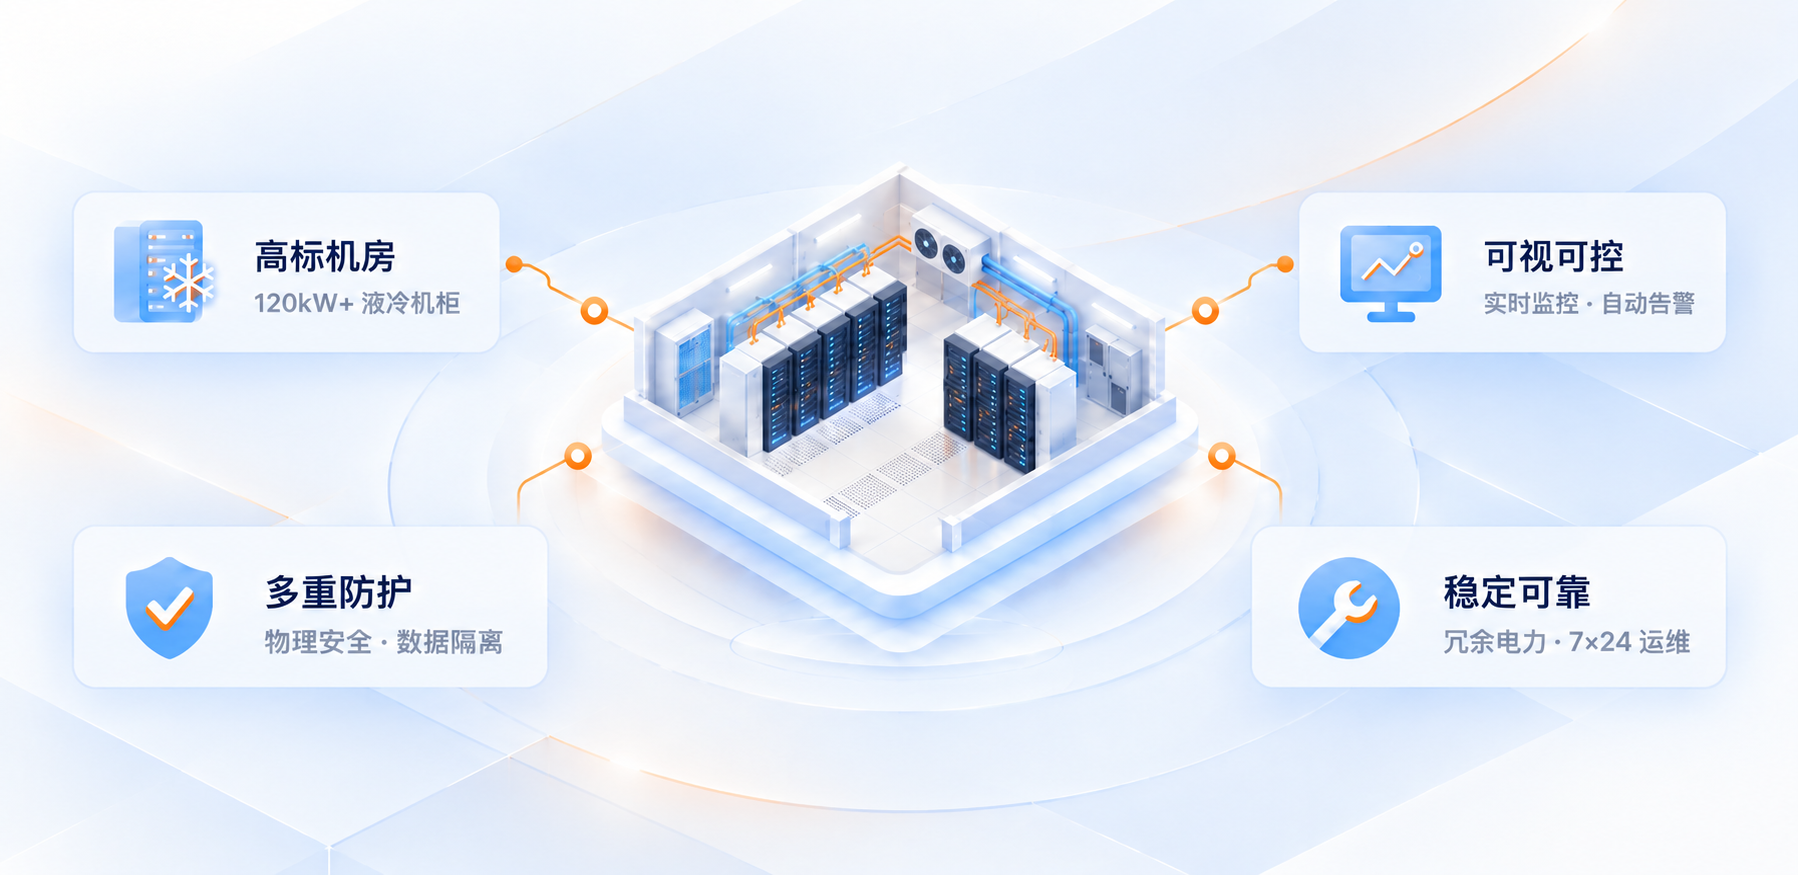
算力托管

GPU 服务器与集群托管,配备 120kW+ 液冷机柜、冗余电力与全天候驻场运维,助力 AI 资产快速投产。

等保三级认证数据物理隔离99.99% SLA 承诺7×24 专人值守

模型生产

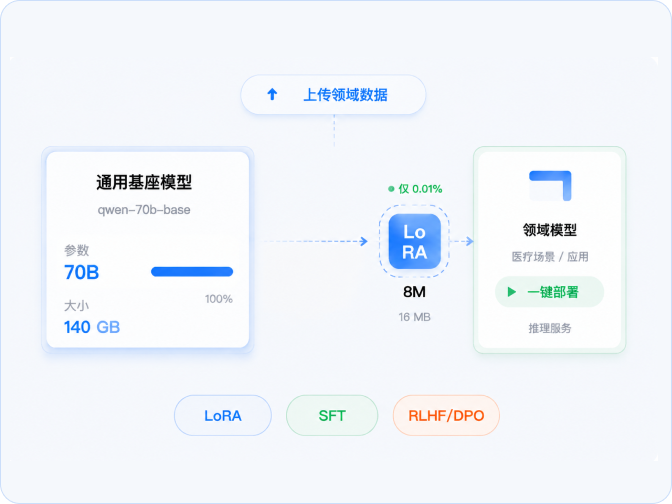
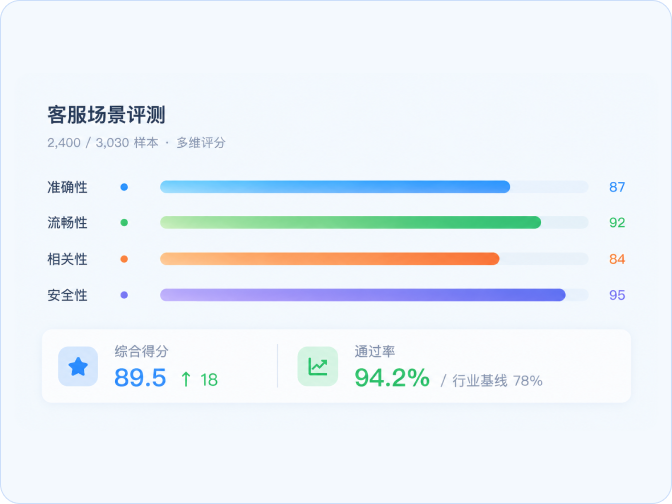
从分布式训练、零代码微调到模型部署,工作台覆盖模型生产全流程

模型微调 · 产品界面示意

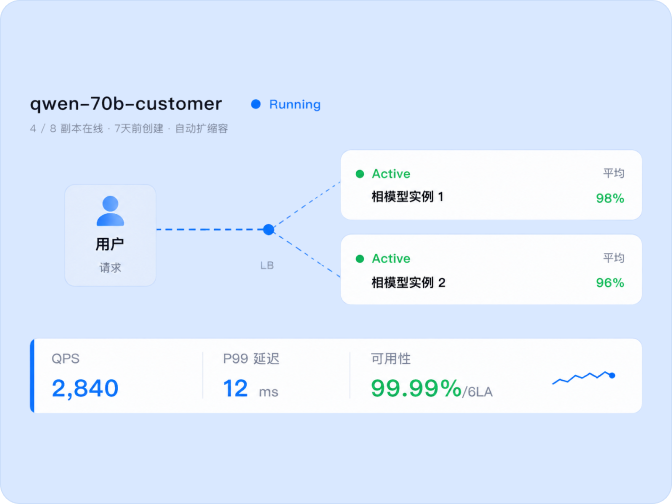
模型部署

将训练或微调后的模型部署上线,提供高性能 API 调用。毫秒级延迟,自动弹性伸缩。

多模型部署弹性伸缩高并发 API流式输出
了解详情
模型部署 · 产品界面示意
模型评估 · 产品界面示意

现在注册,即刻开启 AI 之旅

立即注册